
AI運算的轉折:從算力擴充至架構優化與先進封裝的商業賽局
摘要
AI發展持續從參數規模競爭轉向推論效能優化,硬體架構面臨記憶體頻寬與容量的瓶頸。由於演算法架構的演進反向主導硬體設計,形成更深層的軟硬整合設計,促使半導體產業由2D平面跨入3D異質封裝時代;同時,先進封裝成為決定AI硬體效能的關鍵,使產業競爭從晶圓製造良率升級至對供應鏈生態、材料創新。
一. AI硬體發展由算力堆疊轉向記憶體架構優化
二. 從「算力擴充」轉向「滿足算力」需求,關鍵材料與設備成新戰場
三. 拓墣觀點
圖一 FlashAttention演算法與LLM演進說明
圖二 FP8密集算力、記憶體容量、記憶體頻寬累積增幅
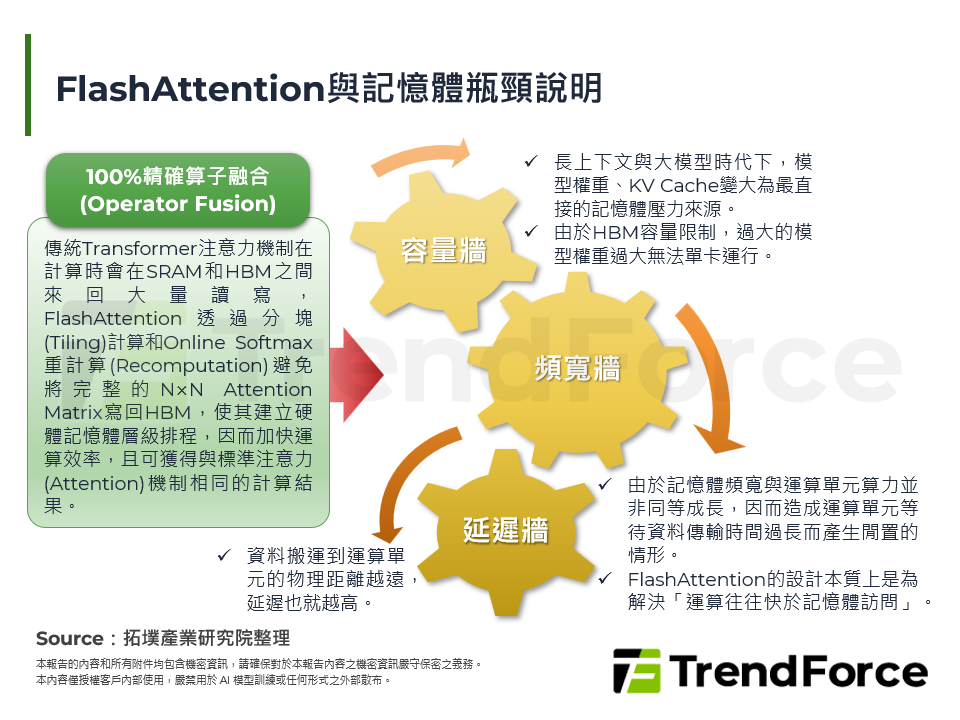
圖三 FlashAttention與記憶體瓶頸說明
圖四 FlashAttention-4與運算架構的影響關係
圖五 CoPoS先進封裝的問題升級路徑
圖六 先進封裝廠商商業策略舉要
表一 NVIDIA H100到R100算力與記憶體規格比較(SXM頂規版本為例)
表二 HBM3e與HBM4核心規格對照
表三 微凸點與矽穿孔技術比較